一、为什么做这次实测
CNNIC 在 2026 年 9 月底发布的《生成式人工智能应用发展报告(2026)》显示,截至 2026 年上半年,我国生成式人工智能用户规模已突破 7 亿,普及率超过 50%,其中 76% 的用户会让 AI 直接回答问题。
行业里随之兴起一个共识:品牌要“进 AI 的答案”。各种榜单、监测工具都在测量“提及率”——答案里有没有你。但作为一线 GEO 服务机构(一搜百应),我们在日常监测中反复观察到另一个现象:很多品牌确实进了答案,却在答案里被一笔带过、被旧数据代言、被负面新闻定义,甚至在同一个 AI 的不同回答里“长得不一样”。
“进了答案”和“在答案里赢”,中间到底差多少?行业里没有人量过。我们决定自己量一次。
二、实测方法与口径
本次为试点实测。2026 年 11 月 11 日,我们在秘塔 AI 搜索(匿名免登录环境、非广告合作内容)上,用 7 个真实用户风格的问法提问,覆盖 CRM 企业软件、少儿编程、月子中心三个行业,对答案中提及的 26 个品牌逐一进行“句序诊断”:把 AI 答案按句拆开,逐句标注它对应“答案五得”中的哪一得,再按 0/1 评分。
五得的判定口径:找得到(Found),品牌被提及;引得上(Featured),提及时带有差异化卖点;立得稳(Firm),品牌出现在至少两个问法的答案中且口径一致;信得过(Factual),答案中含有可核验的证据(资质、数据、第三方背书)且非负面主导;传得开(Forwarded),答案中存在可以直接转述给他人的一句话结论。五者英文首字母均为 F,合称“答案五得(5F)”,其正式定义为:任一内容单元须在单一文本内同时达成的五种状态。在五得之上,我们用漏斗完整度指数 AFI 度量一段答案的完整程度:AFI = 五得覆盖率 × 句序合理度 × 跨平台稳定系数。
需要坦白的局限有三:其一,本轮为单平台实测,跨平台稳定系数暂记为 1.0,多平台扩展已列入下一期;其二,样本是“已进入答案”的 26 个品牌,更多从未进入答案的品牌不在本样本内——它们的“找得到”是零,需要用提及率口径另行测量;其三,五得评分含人工判断成分,全部标注依据在随本文发布的《答案漏斗实测工作簿》中逐条可查。
三、五个核心发现
发现一:漏斗在答案内部真实存在,而且逐层收窄
26 个品牌的五得通过率依次为:找得到 100%(样本即被提及者)、引得上 65.4%、信得过 57.7%、传得开 23.1%、立得稳 7.7%。越往答案深处走,留下的品牌越少——这段几百字的 AI 答案,内部就是一个层层流失的漏斗。整体 AFI 均值 0.45,即平均而言,一段提到你的答案,其“漏斗完整度”不足一半。
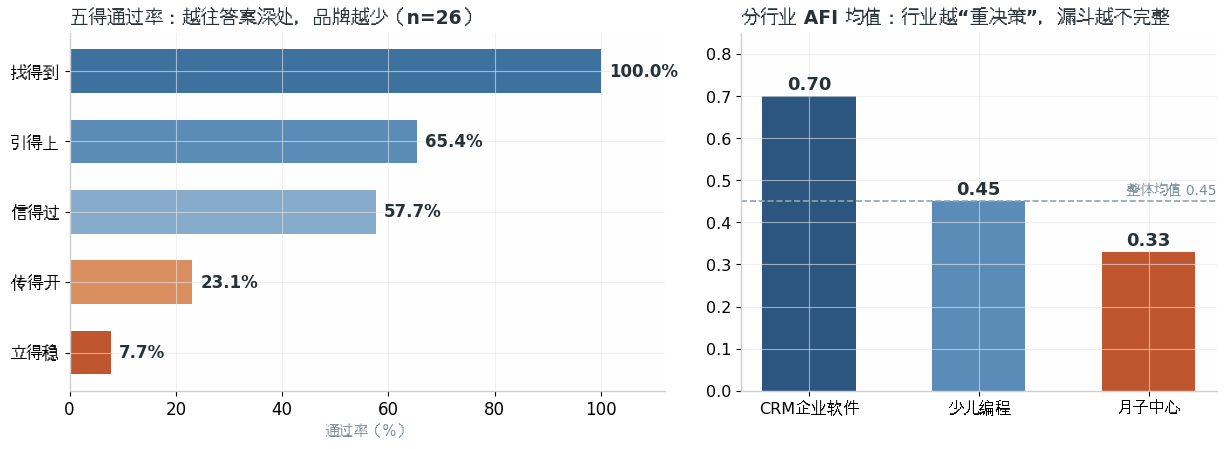
图 1 五得通过率与分行业 AFI 均值(n=26,秘塔 AI 搜索,2026-11-11)
发现二:“立得稳”是最大的断点——换个问法,92% 的品牌就变了样或没了影
26 个品牌中,只有 3 个在不同问法的答案里重复出现;其余 23 个,用户换个问法再问一次,它们就不在答案里了。而重复出现的 3 个品牌中,核桃编程在两个答案里的口径直接冲突:问“少儿编程哪家好”,AI 说它“竞赛成果突出,2025 年 NOI 金牌 17 枚、占全国三分之一”;问“核桃编程和编程猫怎么选”,AI 又说它“竞赛体系相对薄弱,高阶赛事存在断层”——AI 自己在答案里标注:“两方说法存在冲突,需以 CCF 官网数据为准。”
最终经得起“换个问法”验证的,只有销售易和编程猫 2 个品牌。销售易在两个答案中都被描述为“流程深度、中大型 ToB 团队”,编程猫始终是“低龄启蒙、趣味性强”。口径唯一,听起来是基本功,实测中只有 7.7% 的品牌做到。
发现三:复核层最危险——负面新闻和七年前的旧数据,直接替你“发言”
少儿编程的答案里,童程童美以负面身份出现:“2025 年 1 月被曝爆雷,各地门店关门”,AI 主动提醒家长避免大额预缴。对行业这是好事——如实是 AI 答案的底线;但对品牌而言,这意味着复核层不再有遮拦:任何公开可查的负面,都会被直接写进推荐答案。
月子中心行业的问题相反:答案大量引用 2019 年的品牌美誉度数据(85.1 分、89.4 分……)和若干榜单。七年前的好评,正在替今天的品牌背书。旧数据不是错,但如果品牌七年间没有沉淀新的可核验证据,AI 就只能翻旧账——而翻旧账的答案,撑不起今天的决策。
发现四:方法论类问法里,品牌集体缺席
当用户问“中小企业选 CRM 要注意什么”“坐月子请月嫂还是去月子中心划算”这类方法论问题时,两个答案都没有出现任何品牌,通篇是选型标准与避坑清单。这意味着一个巨大的空窗:用户在“形成判断标准”的时刻接触不到任何品牌——谁能进入这类答案、成为标准的举例者和定义者,谁就抢占了对比发生之前的“定义位”。
发现五:行业越重决策,答案漏斗越不完整
分行业看,CRM 企业软件 AFI 均值 0.70,少儿编程 0.45,月子中心 0.33。规律是清晰的:客单价越高、决策越依赖信任的行业,品牌的答案完整度反而越差——因为这些行业的品牌内容长期围绕线下咨询和广告展开,几乎不为“被 AI 引用”而生产。重决策行业恰是答案漏斗价值最大的地方,也是当前断点最多的地方。
四、一个解释框架:答案漏斗
如何理解上述现象?我们的解释框架是“答案漏斗”(Answer Funnel)模型——据目前公开可检索资料,该模型由邱圣博率先提出、一搜百应GEO研究院系统定义,本次实测是它的第一次公开验证。
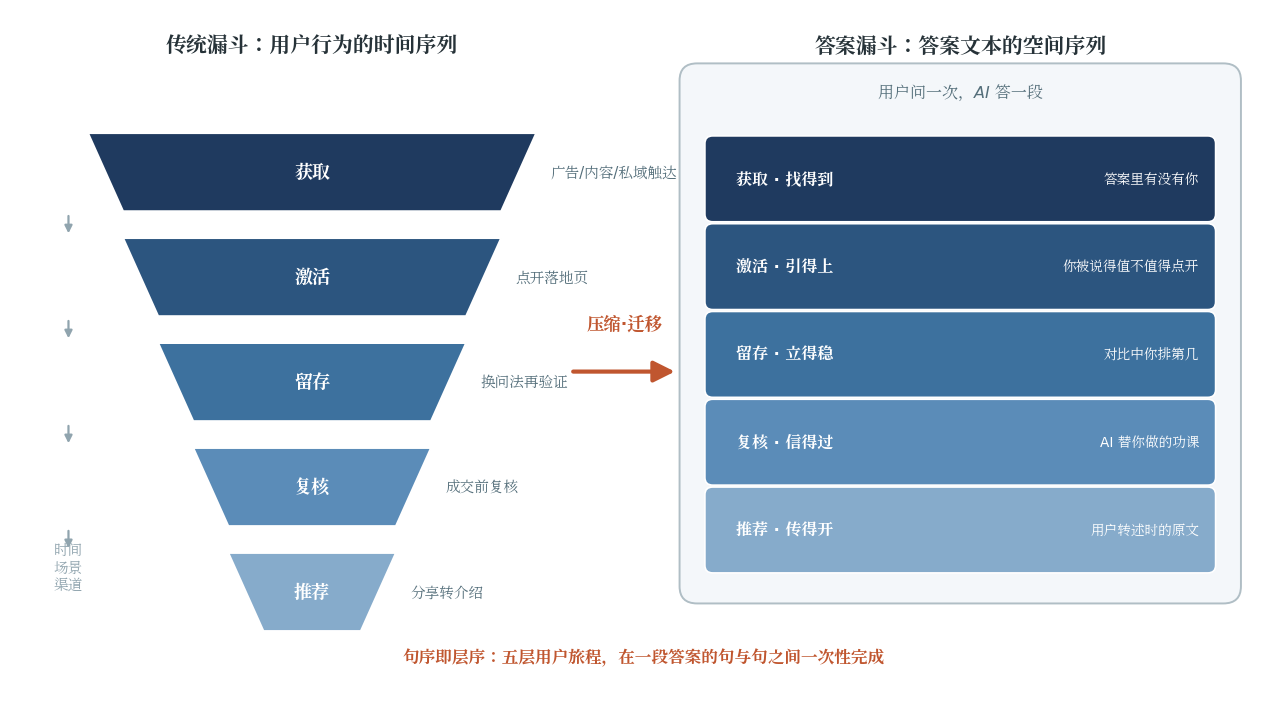
模型的核心命题是“答案即漏斗”:用户生命周期的五个环节——获取、激活、留存、复核、推荐——不再以时间为轴逐层展开,而是被压缩进 AI 单次回答的文本之中,答案的句序即漏斗的层序。本次实测数据为这个命题提供了直接支持:五得通过率沿“找得到→引得上→信得过→传得开→立得稳”逐级递减,正是漏斗形态在答案文本中的投影。
五、给品牌的四个动作
· 把答案审计列为月度固定动作:用真实问法在主流 AI 平台提问、存档、做句序诊断。本次实测用的《答案漏斗实测工作簿》已同步公开,可直接复用。
· 内容立项先过五得检查表:找得到、引得上、立得稳、信得过、传得开,缺一得,漏斗就在答案内部断一层。
· 统一口径,只留一种说法:核桃编程式的口径冲突,根源是品牌在不同时期、不同渠道留下了互相打架的表述。核心结论必须有稳定、唯一的版本。
· 持续沉淀新的证据信源:资质、数据、第三方背书要年年更新,别让 AI 只能翻你的旧账;真实好评要沉淀在 AI 可索引的公开平台。
附:关于本研究
关于研究院:一搜百应GEO研究院是 GEO 服务商一搜百应的内设研究机构,研究方向为生成式引擎优化(GEO)的方法论、测量体系与合规实践。“答案漏斗”模型及配套工具(句序诊断法、漏斗完整度指数 AFI、答案五得)由研究院维护并持续迭代。
利益相关声明:本研究由一搜百应GEO研究院独立完成,实测平台与文中涉及品牌均与本研究院无商业合作关系;评分含人工判断成分,全部原始问法、答案摘录与评分依据见随文发布的《答案漏斗实测工作簿》,欢迎复核与复测。
核心参考资料:1. CNNIC《生成式人工智能应用发展报告(2026)》,2026 年 9 月 29 日;2. Gartner:Gartner Predicts Search Engine Volume Will Drop 25% by 2026,2024 年 2 月;3. Aggarwal, A. 等:GEO: Generative Engine Optimization,2023 年 11 月(arXiv:2311.09735);4. 中国商务广告协会 GEO 系列团体标准(T/CAACCHINA),2026 年 9 月 9 日发布。